Claude Opus 5.5 vs Sonnet 5.5 vs Haiku 5.5 : lequel choisir
Claude Opus 5.5, Sonnet 5.5 ou Haiku 5.5 ? Prix API, benchmarks officiels et guide de décision par usage : code, agents, sous-agents, browser use, volume.
Choisissez Claude Sonnet 5.5 pour la majorité du code et des agents, Claude Opus 5.5 pour les tâches longues et difficiles où chaque point de qualité compte, et Claude Haiku 5.5 pour le volume, les sous-agents et le temps réel. Sonnet 5.5 coûte deux fois moins cher qu’Opus 5.5 et le dépasse même sur Terminal-Bench 4.0 (70,6 % contre 66,4 %), tandis que Haiku 5.5 est 40 fois moins cher qu’Opus sur les prompts de moins de 100 000 tokens.
Anthropic a sorti les trois modèles de la famille Claude 5.5 en quinze jours : Opus 5.5 le 22 septembre, Sonnet 5.5 le 28 septembre et Haiku 5.5 le 7 octobre 2026. Les blogs qui ont couvert ces lancements publient des prix et des dates qui divergent. Tous les chiffres de ce comparatif proviennent des annonces officielles d’Anthropic et de sa documentation API, consultées le 28 octobre 2026.
Claude 5.5 en un tableau : prix, contexte et positionnement
La différence principale entre les trois modèles tient au prix et à la vitesse, pas aux fonctionnalités. Tous partagent la même fenêtre de contexte (1 million de tokens), la même sortie maximale (128 000 tokens), la même coupure de connaissances (juin 2026) et les cinq mêmes niveaux d’effort.
| Critère | Claude Opus 5.5 | Claude Sonnet 5.5 | Claude Haiku 5.5 |
|---|---|---|---|
| Date de sortie | 22 septembre 2026 | 28 septembre 2026 | 7 octobre 2026 |
| Identifiant API | claude-opus-5-5 | claude-sonnet-5-5 | claude-haiku-5-5 |
| Positionnement officiel | Code agentique long et travail intellectuel | Compromis vitesse / intelligence | Volume, latence, classification, routage |
| Latence relative | Modérée | Rapide | La plus rapide |
| Entrée (par million de tokens) | 4 $ | 2 $ | 0,10 $ (jusqu’à 100K) / 0,50 $ (au-delà) |
| Sortie (par million de tokens) | 20 $ | 10 $ | 0,50 $ (jusqu’à 100K) / 2,50 $ (au-delà) |
| Contexte | 1M tokens | 1M tokens | 1M tokens |
| Sortie maximale | 128K tokens | 128K tokens | 128K tokens |
| Effort par défaut (API) | medium | high | medium |
Source : vue d’ensemble des modèles, documentation Claude, octobre 2026.
Au-dessus de cette gamme se trouve Claude Fable 5.1 (10 $ / 50 $), réservé au raisonnement le plus exigeant. Je le détaille dans mon guide Claude Fable 5.1 et Mythos 5.1. Pour la plupart des équipes, le choix se joue entre les trois modèles 5.5.
La grille tarifaire complète de Claude 5.5
L’écart de prix entre le haut et le bas de gamme atteint 40x. Sur un prompt de moins de 100 000 tokens, Opus 5.5 coûte 4 $ en entrée contre 0,10 $ pour Haiku 5.5, et 20 $ en sortie contre 0,50 $. Le rapport est identique dans les deux sens.
Prix détaillés par million de tokens
| Ligne tarifaire | Opus 5.5 | Sonnet 5.5 | Haiku 5.5 (≤ 100K) | Haiku 5.5 (> 100K) |
|---|---|---|---|---|
| Entrée | 4 $ | 2 $ | 0,10 $ | 0,50 $ |
| Écriture cache 5 min | 5 $ | 2,50 $ | 0,125 $ | 0,625 $ |
| Écriture cache 1 h | 8 $ | 4 $ | 0,20 $ | 1 $ |
| Lecture cache | 0,20 $ | 0,10 $ | 0,01 $ | 0,05 $ |
| Sortie | 20 $ | 10 $ | 0,50 $ | 2,50 $ |
| Batch entrée / sortie | 2 $ / 10 $ | 1 $ / 5 $ | 0,05 $ / 0,25 $ | 0,25 $ / 1,25 $ |
Source : page Pricing de la documentation Claude.
Trois points méritent votre attention dans cette grille.
Le seuil des 100 000 tokens de Haiku 5.5. Haiku est le seul modèle de la famille facturé selon la longueur du prompt. Le seuil inclut tous les tokens d’entrée, y compris les lectures et écritures de cache. Une requête de 120 000 tokens paie entièrement le tarif supérieur, même si 100 000 de ces tokens viennent du cache.
Selon Anthropic, 90 % des requêtes envoyées à Haiku 4.5 restaient sous ce seuil. Haiku 5.5 coûte environ 90 % de moins que Haiku 4.5 sous 100 000 tokens, 50 % de moins au-delà, et environ 75 % de moins en moyenne.
La lecture de cache de Sonnet 5.5 divisée par deux. Avec la sortie de Haiku 5.5 le 7 octobre, Anthropic a baissé la lecture de cache de Sonnet 5.5 de 0,20 $ à 0,10 $ par million de tokens. L’éditeur estime l’économie à environ 20 % sur la plupart des travaux agentiques, qui relisent sans cesse le même contexte.
Opus 5.5 moins cher qu’Opus 5. Opus 5.5 passe à 4 $ / 20 $, contre 5 $ / 25 $ pour Opus 5 ; la lecture de cache tombe de 0,50 $ à 0,20 $. Anthropic annonce un coût d’exécution inférieur de 40 % à Opus 5 « sur des charges de travail typiques » au réglage par défaut, un gain qui vient aussi d’une consommation de tokens plus sobre.
Si vous venez d’Opus 5, mon guide Claude Opus 5 rappelle les bases du réglage d’effort, qui s’applique toujours.
Ce que coûte un million de requêtes
Prenons une requête type d’agent : 20 000 tokens en entrée, 2 000 en sortie, sans cache. Voici le coût unitaire et le coût pour un million d’appels.
| Modèle | Coût par requête | Coût pour 1 million de requêtes |
|---|---|---|
| Opus 5.5 | 0,12 $ | 120 000 $ |
| Sonnet 5.5 | 0,06 $ | 60 000 $ |
| Haiku 5.5 | 0,003 $ | 3 000 $ |
Sur un prompt de 150 000 tokens, Haiku 5.5 bascule au tarif supérieur : la même requête avec 2 000 tokens de sortie coûte 0,08 $, contre 0,32 $ pour Sonnet 5.5 et 0,64 $ pour Opus 5.5. Haiku reste quatre fois moins cher que Sonnet, mais l’écart de 40x avec Opus se réduit à 8x.
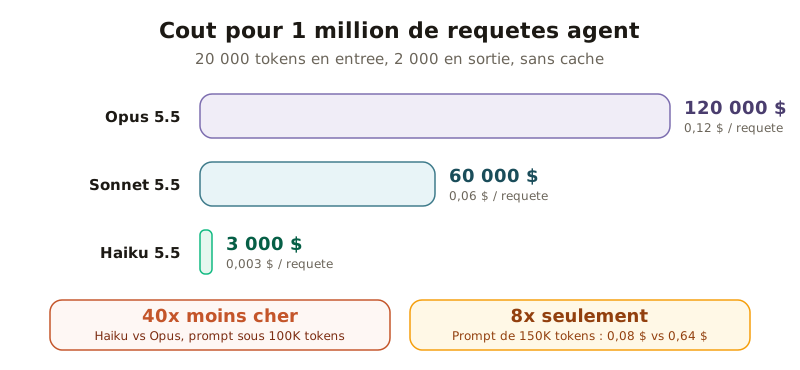 Un million de requêtes agent coûte 120 000 $ avec Opus 5.5, contre 3 000 $ avec Haiku 5.5 : 40 fois moins, un écart qui tombe à 8x au-delà de 100 000 tokens.
Benchmarks Claude 5.5 : ce que disent les chiffres officiels
Sonnet 5.5 fait presque jeu égal avec Opus 5.5, et le dépasse sur un benchmark clé. Haiku 5.5 décroche nettement sur le code agentique, mais reste solide en connaissances générales et en travail de bureau.
| Benchmark | Opus 5.5 | Sonnet 5.5 | Haiku 5.5 |
|---|---|---|---|
| Terminal-Bench 4.0 (code agentique en terminal) | 66,4 % | 70,6 % | 39,2 % |
| FrontierCode 1.1 Main (code) | 54,4 % | 52,1 % (xhigh) | 46,4 % |
| CursorBench 4.0 (code dans un IDE) | 57,8 % | 55,5 % | non publié |
| GDPval-AA v2.1 (travail de bureau, Elo) | 1 846 | 1 844 | 1 620 |
| Humanity’s Last Exam, avec outils | 67,7 % | 64,5 % | 57,4 % |
| OSWorld 2.1 partiel (usage d’ordinateur) | 81,8 % | 80,1 % | non publié |
| Chartography sans outils (lecture de graphiques) | 64,4 % | 61,6 % | 46,4 % |
Sources : annonces officielles de Sonnet 5.5 et de Haiku 5.5. Les scores d’Opus 5.5 sont mesurés en effort max, sauf Terminal-Bench 4.0 (xhigh).
Deux précautions de lecture s’imposent. Les scores publiés sont en général obtenus aux niveaux d’effort élevés (xhigh ou max), pas aux réglages par défaut que vous utiliserez en production. Et Anthropic mesure Haiku 5.5 sur OSWorld 2.1 avec un sous-ensemble différent (« offline subset », 72,4 %), qui n’est donc pas comparable au 80,1 % de Sonnet ni au 81,8 % d’Opus.
Ce qu’il faut retenir des benchmarks
- Sonnet 5.5 reste à moins de 3,5 points d’Opus 5.5 sur les six benchmarks où Opus mène, et le dépasse de 4,2 points sur Terminal-Bench 4.0.
- Haiku 5.5 progresse fortement face à Haiku 4.5, qui obtenait 0,0 % sur Terminal-Bench 4.0 et 735 Elo sur GDPval-AA (contre 39,2 % et 1 620 pour Haiku 5.5).
- Sur GDPval-AA, Haiku 5.5 dépasse Sonnet 5 de la génération précédente (1 620 contre 1 449 Elo), ce qui le rend crédible pour de la rédaction, de l’analyse et de la synthèse de documents.
Anthropic le dit d’ailleurs explicitement dans l’annonce de Haiku 5.5 : Sonnet 5.5 et Opus 5.5 restent mieux adaptés au code agentique complexe du type Terminal-Bench 4.0.
Quel modèle Claude choisir selon votre usage
La règle que j’applique : partir du modèle le moins cher qui réussit votre tâche, en testant d’abord un effort plus élevé avant de monter de gamme. La documentation d’Anthropic va dans le même sens : « régler l’effort est souvent un meilleur levier que changer de modèle ».
| Usage | Modèle recommandé | Pourquoi |
|---|---|---|
| Code au quotidien, revue de code, debug | Sonnet 5.5 | 70,6 % sur Terminal-Bench 4.0, deux fois moins cher qu’Opus |
| Refactoring de grande ampleur, migration, agent autonome de plusieurs heures | Opus 5.5 | Meilleurs scores sur FrontierCode et CursorBench, conçu pour les tâches longues |
| Orchestrateur d’un système multi-agents | Opus 5.5 ou Sonnet 5.5 | Décisions de planification, où les erreurs se propagent |
| Sous-agents (recherche, lecture de fichiers, résumés) | Haiku 5.5 | 40x moins cher qu’Opus, latence la plus faible |
| Browser use et support client en temps réel | Haiku 5.5 | Positionné par Anthropic sur les tâches sensibles à la vitesse |
| Computer use exigeant (applications de bureau) | Opus 5.5 ou Sonnet 5.5 | 81,8 % et 80,1 % sur OSWorld 2.1 |
| Classification, extraction, routage à fort volume | Haiku 5.5 | Coût marginal de 0,003 $ par requête type |
| Raisonnement de recherche, analyses de plusieurs heures | Fable 5.1, puis Opus 5.5 | Fable si Opus en xhigh ou max ne suffit pas |
Code et développement : Sonnet 5.5 par défaut
Pour le code, Sonnet 5.5 est le choix rationnel en 2026. Il obtient le meilleur score de la famille sur Terminal-Bench 4.0 et 55,5 % sur CursorBench 4.0, à 2,3 points d’Opus 5.5. SpaceXAI, cité par Anthropic, note qu’il atteint « des performances de niveau frontière sur CursorBench 4.0, à 55,5 %, juste derrière Opus 5.5 ». Sur 118 constructions d’applications réelles, la même équipe mesure 3,6 itérations par application pour Sonnet 5.5, contre 7,7 pour Opus 5, à qualité égale.
Gardez Opus 5.5 pour les chantiers où la qualité prime sur le coût : réécriture d’un module complexe, migration de langage, audit de sécurité. Dans l’annonce d’Opus 5.5, Stripe raconte une session Opus 5.5 qui a piloté une douzaine d’autres sessions pour rebaser 40 pull requests empilées : toutes passaient la CI dès le lendemain après-midi. Ce type de tâche longue et dense en décisions justifie de payer deux fois plus.
Agents et orchestration : Opus ou Sonnet en chef, Haiku en exécutant
Le schéma le plus économique pour un agent combine deux modèles. Un orchestrateur (Opus 5.5 ou Sonnet 5.5) planifie et prend les décisions difficiles, puis délègue le travail répétitif à des sous-agents Haiku 5.5. La documentation d’Anthropic sur le choix du modèle décrit ce schéma « orchestrateur et travailleurs » : la majorité des tokens est ainsi facturée au tarif le plus bas.
Si vous concevez ce type de système, mon guide sur l’architecture multi-agents détaille les patterns de délégation. Dans Claude Code, le mode qui lance des centaines de sous-agents est présenté dans mon article sur ultracode et les dynamic workflows : c’est précisément là que le prix unitaire des sous-agents pèse sur la facture.
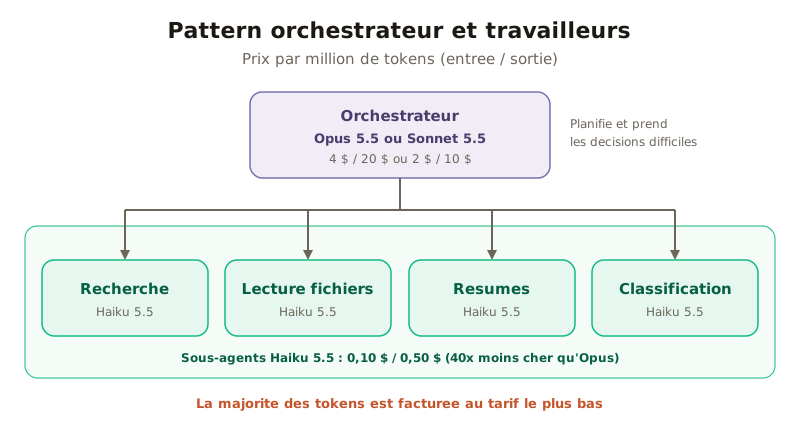 Opus ou Sonnet décide, Haiku 5.5 exécute à 0,10 $ / 0,50 $ par million de tokens : la majorité des tokens passe au tarif le plus bas.
Sous-agents, résumés et volume : Haiku 5.5
Haiku 5.5 est le modèle à privilégier dès que la tâche est courte, bien cadrée et répétée des milliers de fois. Anthropic cite les résumés, le compactage de contexte, les requêtes en base de données et la classification.
J’utilise Haiku 5.5 dans mon moteur de recherche personnel : il rédige des fiches résumées en JSON par lots de 12 documents (environ 25 secondes par lot), et propose des requêtes alternatives quand une recherche par mots-clés renvoie moins de 3 résultats, en 5 secondes environ. Sur les échantillons que j’ai vérifiés, les fiches restent fidèles au texte source. Je garde pourtant un garde-fou : la sortie est validée à chaque appel, et un document qui échoue trois fois est mis de côté plutôt que de bloquer le traitement.
HubSpot, cité dans l’annonce, indique que Haiku 5.5 a obtenu « le meilleur score jamais vu sur cette suite, à 92,8 % en moyenne sur trois passages ». Rogo résume bien son créneau : « les tâches courtes et à fort volume, comme les recherches rapides, les sous-agents et les résumés ».
Browser use et temps réel : Haiku 5.5, avec un garde-fou
Pour un agent qui navigue sur le web ou répond en direct à des clients, la latence compte autant que l’intelligence. Haiku 5.5 est le modèle le plus rapide de la gamme et Anthropic le recommande explicitement pour le browser use et le support client en temps réel.
Pour du computer use exigeant (piloter un logiciel de bureau, enchaîner des formulaires complexes), les scores OSWorld 2.1 d’Opus 5.5 (81,8 %) et de Sonnet 5.5 (80,1 %) offrent plus de marge. Une approche pragmatique consiste à laisser Haiku gérer les parcours simples et à basculer vers Sonnet en cas d’échec.
Régler l’effort avant de changer de modèle
Les trois modèles 5.5 proposent cinq niveaux d’effort : low, medium, high, xhigh et max. Haiku 5.5 est le premier modèle Haiku à offrir ce réglage. Plus l’effort monte, plus le modèle réfléchit, et plus il consomme de tokens de sortie.
| Modèle | Effort par défaut sur l’API |
|---|---|
| Opus 5.5 | medium |
| Sonnet 5.5 | high (medium dans Claude Code et les applications Claude) |
| Haiku 5.5 | medium |
Conséquence pratique : avant de passer de Sonnet à Opus, essayez Sonnet en xhigh. Sur FrontierCode 1.1, Sonnet 5.5 passe de 46,2 % en max à 52,1 % en xhigh selon Anthropic, preuve que l’effort maximal n’est pas toujours le meilleur réglage. À l’inverse, baisser l’effort d’Opus peut suffire : Deloitte rapporte qu’Opus 5.5 en effort minimal détectait 72 % des bugs connus dans ses revues de code, contre 56 % pour Opus 5 en effort élevé.
Mon verdict : Sonnet 5.5 comme modèle par défaut
Pour la majorité des développeurs et des équipes qui construisent des agents, Sonnet 5.5 devrait devenir le modèle par défaut. Il coûte deux fois moins cher qu’Opus 5.5, fait jeu égal sur la plupart des benchmarks et le dépasse sur Terminal-Bench 4.0. Opus 5.5 se justifie sur les tâches longues et à fort enjeu, Haiku 5.5 sur tout ce qui se répète en volume.
Une nuance s’impose : Anthropic recommande, dans sa documentation, de démarrer la plupart des charges de travail avec Opus 5.5, puis d’optimiser vers des modèles moins chers. Les deux approches se défendent, et le bon choix dépend de votre budget de départ. Dans tous les cas, construisez un jeu de tests sur vos propres prompts avant de trancher : les benchmarks publics ne remplacent pas vos données.
Si vous utilisez Claude via un abonnement plutôt qu’en API, gardez en tête que les appels programmatiques (SDK, agents) sont facturés au tarif API depuis juin 2026, comme je l’explique dans mon article sur la facturation de l’usage programmatique de Claude. Le choix du modèle a alors un impact direct sur votre crédit. Pour revoir l’évolution de la gamme intermédiaire, mon guide Claude Sonnet 5 reste la référence sur la génération précédente.
Questions fréquentes
Quel modèle Claude 5.5 choisir par défaut ?
Pour du code et des agents au quotidien, Claude Sonnet 5.5 est le meilleur compromis : il coûte deux fois moins cher qu'Opus 5.5 (2 $ contre 4 $ par million de tokens en entrée, 10 $ contre 20 $ en sortie) et le dépasse sur Terminal-Bench 4.0 (70,6 % contre 66,4 %). Anthropic recommande de son côté de démarrer avec Opus 5.5 pour la plupart des charges de travail complexes. Haiku 5.5 est à réserver aux tâches à fort volume, aux sous-agents et aux usages sensibles à la latence.
Combien coûtent Claude Opus 5.5, Sonnet 5.5 et Haiku 5.5 en API ?
Selon la grille officielle d'Anthropic, Opus 5.5 coûte 4 $ par million de tokens en entrée et 20 $ en sortie. Sonnet 5.5 coûte 2 $ en entrée et 10 $ en sortie. Haiku 5.5 coûte 0,10 $ en entrée et 0,50 $ en sortie pour les prompts jusqu'à 100 000 tokens, puis 0,50 $ et 2,50 $ au-delà. L'API Batch divise tous ces prix par deux.
Claude Sonnet 5.5 est-il meilleur qu'Opus 5.5 ?
Pas sur tout. Sonnet 5.5 devance Opus 5.5 sur Terminal-Bench 4.0 (70,6 % contre 66,4 %), un benchmark de tâches agentiques en terminal. Opus 5.5 reste devant sur FrontierCode 1.1 (54,4 % contre 52,1 % pour Sonnet en effort xhigh), CursorBench 4.0 (57,8 % contre 55,5 %), Humanity's Last Exam avec outils (67,7 % contre 64,5 %) et OSWorld 2.1 (81,8 % contre 80,1 %). Les écarts sont faibles, alors que Sonnet coûte deux fois moins cher.
À quoi sert Claude Haiku 5.5 ?
Haiku 5.5 est conçu pour les tâches à fort volume et sensibles au coût ou à la latence : résumés, compactage de contexte, requêtes en base de données, classification, support client en temps réel et browser use. Anthropic le présente aussi comme sous-agent d'Opus 5.5 ou de Sonnet 5.5 dans les workflows de code. C'est le premier Haiku doté d'un réglage d'effort (low à max).
Quelle est la fenêtre de contexte des modèles Claude 5.5 ?
Opus 5.5, Sonnet 5.5 et Haiku 5.5 acceptent tous 1 million de tokens en entrée et jusqu'à 128 000 tokens en sortie sur l'API Messages synchrone. Leur date de coupure des connaissances fiables est juin 2026. Attention : sur Haiku 5.5, un prompt de plus de 100 000 tokens est facturé au tarif supérieur (0,50 $ / 2,50 $), alors qu'Opus et Sonnet facturent tout le contexte au prix standard.
Pourquoi Haiku 5.5 est-il 40 fois moins cher qu'Opus 5.5 ?
Sur les prompts de moins de 100 000 tokens, Haiku 5.5 est facturé 0,10 $ en entrée et 0,50 $ en sortie par million de tokens, contre 4 $ et 20 $ pour Opus 5.5 : le rapport est exactement de 1 à 40. Haiku est un modèle plus petit et plus rapide. Il obtient 39,2 % sur Terminal-Bench 4.0 contre 66,4 % pour Opus 5.5, ce qui le rend moins adapté au code agentique complexe.
Quel niveau d'effort utiliser avec Claude 5.5 ?
Les trois modèles proposent cinq niveaux d'effort : low, medium, high, xhigh et max. Sur l'API, l'effort par défaut est medium pour Opus 5.5 et Haiku 5.5, high pour Sonnet 5.5. Dans Claude Code et les applications Claude, Sonnet 5.5 tourne en medium par défaut. Anthropic indique que régler l'effort est souvent un meilleur levier que changer de modèle.
Faut-il passer de Claude Haiku 4.5 à Haiku 5.5 ?
Oui, dans la quasi-totalité des cas. Selon Anthropic, Haiku 5.5 coûte environ 90 % de moins que Haiku 4.5 pour les prompts jusqu'à 100 000 tokens (0,10 $ contre 1 $ en entrée, 0,50 $ contre 5 $ en sortie par million de tokens), 50 % de moins au-delà, et environ 75 % de moins en moyenne. Il est aussi bien plus performant : 39,2 % sur Terminal-Bench 4.0 contre 0,0 % pour Haiku 4.5, et 1 620 Elo sur GDPval-AA v2.1 contre 735.
Quelles sont les dates de sortie de Claude Opus 5.5, Sonnet 5.5 et Haiku 5.5 ?
Anthropic a lancé Claude Opus 5.5 le 22 septembre 2026, Claude Sonnet 5.5 le 28 septembre 2026 et Claude Haiku 5.5 le 7 octobre 2026. Les trois modèles sont disponibles sur l'API Claude, Amazon Bedrock, Google Cloud et Microsoft Foundry.