Claude Fable 5.2 et Mythos 5.2 : guide, prix et nouveautés
Claude Fable 5.2 et Mythos 5.2 : prix API en baisse de 20 %, benchmarks, fast mode, accès et quand le préférer à Opus 5.5 ou Sonnet 5.5.
Claude Fable 5.2 est la nouvelle version du modèle de frontière d’Anthropic, sortie le 9 novembre 2026 : il coûte 20 % de moins que Fable 5.1 (8 $ / 40 $ par million de tokens au lieu de 10 $ / 50 $) et répond jusqu’à 30 % plus vite. Mythos 5.2 est le même modèle avec des garde-fous assouplis en cybersécurité et en biologie, toujours réservé à des organisations vérifiées.
Le saut de capacité est plus marqué que celui de la version 5.1. Sur FrontierSWE v2, Fable 5.2 passe à 69,9 % contre 56,3 % pour Fable 5.1, et sur le Remote Labor Index il grimpe à 41,3 % (en effort high) contre 17,9 %, selon l’annonce officielle d’Anthropic. Je détaille ici ce qui change face à Fable 5.1, la grille tarifaire complète et, surtout, quand Fable 5.2 vaut son prix face à Opus 5.5 ou Sonnet 5.5 dans vos automatisations.
Fable 5.2 vs Fable 5.1 : ce qui change en un tableau
Fable 5.2 est moins cher, plus rapide et plus capable que Fable 5.1, sans changer de positionnement : il reste le palier « escalade » de la gamme Claude, au-dessus d’Opus 5.5. Si vous découvrez la nomenclature Fable / Mythos, mon guide Claude Fable 5.1 et Mythos 5.1 reste la référence historique sur la génération précédente et sur la logique « un modèle, deux niveaux de garde-fous ».
| Critère | Fable 5.2 | Fable 5.1 |
|---|---|---|
| Date de sortie | 9 novembre 2026 | 1er septembre 2026 |
| Identifiant API | claude-fable-5-2 | claude-fable-5-1 |
| Entrée / sortie (par million de tokens) | 8 $ / 40 $ | 10 $ / 50 $ |
| Lecture de cache | 0,20 $ | 0,25 $ |
| Vitesse de sortie | Jusqu’à 30 % plus rapide | Référence |
| Fast mode | Oui (16 $ / 80 $, jusqu’à 2,5x plus rapide) | Non proposé |
| Niveaux d’effort | low, medium, high, xhigh, max | low, medium, high, xhigh, max |
| Blocages des garde-fous | Environ 55 % de moins | Référence |
Sources : annonce Anthropic du 9 novembre 2026 et page Pricing de la documentation Claude, consultées le 16 novembre 2026.
Trois changements comptent vraiment pour un usage en production : la baisse de prix uniforme, l’arrivée du fast mode et la réduction des faux positifs des garde-fous. Anthropic indique aussi que Fable 5.2 consomme moins de tokens que Fable 5.1 en effort medium, ce qui ajoute une économie au-delà de la seule baisse de tarif.
Des garde-fous moins intrusifs
Fable 5.2 conserve des protections aussi robustes que Fable 5.1 selon Anthropic, mais elles se déclenchent environ 55 % moins souvent. La baisse atteint environ 60 % en cybersécurité et environ 40 % en biologie.
Concrètement, une requête bloquée n’est pas laissée sans réponse : elle est redirigée vers un modèle plus ancien, Opus 4.8 pour la cybersécurité et Opus 5 pour la biologie. Pour une équipe sécurité qui utilisait Fable 5.1 et se heurtait à des refus sur des tâches légitimes, c’est probablement le changement le plus sensible au quotidien.
Prix de Claude Fable 5.2 : la grille complète
Fable 5.2 baisse de 20 % chaque ligne tarifaire de Fable 5.1, cache et Batch compris. Mythos 5.2 est facturé exactement au même prix. J’ai vérifié ces chiffres directement sur la documentation officielle, car les articles de lancement ne donnent souvent que le couple entrée / sortie.
| Ligne tarifaire (par million de tokens) | Fable 5.2 / Mythos 5.2 | Fable 5.1 / Mythos 5.1 | Opus 5.5 |
|---|---|---|---|
| Entrée | 8 $ | 10 $ | 4 $ |
| Écriture de cache 5 min | 10 $ | 12,50 $ | 5 $ |
| Écriture de cache 1 h | 16 $ | 20 $ | 8 $ |
| Lecture de cache | 0,20 $ | 0,25 $ | 0,20 $ |
| Sortie | 40 $ | 50 $ | 20 $ |
| Batch entrée / sortie | 4 $ / 20 $ | 5 $ / 25 $ | 2 $ / 10 $ |
| Fast mode entrée / sortie | 16 $ / 80 $ | Non proposé | 8 $ / 40 $ |
Source : page Pricing de la documentation Claude, novembre 2026.
Un détail m’a frappé en comparant les grilles : la lecture de cache de Fable 5.2 (0,20 $) est désormais au même prix que celle d’Opus 5.5. Sur un agent qui relit en permanence un gros contexte stable, l’écart de coût entre les deux modèles se concentre donc sur les tokens neufs et sur la sortie, pas sur le contexte en cache.
Le fast mode : deux fois le prix pour 2,5 fois la vitesse
Le fast mode accélère la génération jusqu’à 2,5 fois, pour un tarif doublé (16 $ / 80 $). Il est disponible dans Claude Code, sur l’API Claude, sur Google Cloud (versions gérées par Anthropic et par Google) et sur Microsoft Foundry pour les déploiements hébergés par Anthropic. Il ne se combine pas avec l’API Batch.
Je le réserve aux sessions interactives où vous attendez la réponse devant l’écran, par exemple une session de debug dans Claude Code. Pour un workflow d’automatisation qui tourne la nuit, la vitesse n’a aucune valeur : le Batch à 4 $ / 20 $ est quatre fois moins cher que le fast mode.
Ce que coûte une requête type
Prenons la même requête d’agent que dans mon comparatif Opus, Sonnet et Haiku 5.5 : 20 000 tokens en entrée, 2 000 en sortie, sans cache.
| Modèle | Coût par requête | Coût pour 1 million de requêtes |
|---|---|---|
| Fable 5.1 | 0,30 $ | 300 000 $ |
| Fable 5.2 | 0,24 $ | 240 000 $ |
| Opus 5.5 | 0,12 $ | 120 000 $ |
| Sonnet 5.5 | 0,06 $ | 60 000 $ |
Ce calcul à tokens égaux est trompeur pour un modèle de raisonnement. En pratique, le nombre de tokens de sortie dépend fortement du niveau d’effort, et c’est là que Fable 5.2 peut renverser la comparaison, comme le montre la section sur le coût par tâche plus bas.
Benchmarks de Fable 5.2 : les chiffres d’Anthropic
Fable 5.2 dépasse Fable 5.1 sur tous les benchmarks publiés et devance Opus 5.5 sur presque tous. Les gains les plus nets portent sur le travail agentique long : Remote Labor Index, robotique simulée et science en terminal. Pour l’automatisation, le chiffre à retenir est AutomationBench (workflows métier) : 51,4 % contre 42,5 % pour Opus 5.5, même si Gemini 4 Carbon reste devant avec 53,9 %.
| Benchmark | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra |
|---|---|---|---|---|
| FrontierCode 2.0 (code agentique) | 49,1 % (xhigh) | 32,4 % (xhigh) | 45,5 % | 42,8 % |
| FrontierSWE v2 | 69,9 % | 56,3 % | 62,3 % | 65,5 % |
| Terminal-Bench-Science 0.1 | 74,6 % | 52,6 % | 58,7 % | 68,1 % |
| OSWorld 2.1 offline (usage d’ordinateur) | 89,3 % | 83,5 % | 87,2 % | 79,5 % |
| AutomationBench (workflows métier) | 51,4 % | 31,4 % | 42,5 % | 41,4 % |
| Remote Labor Index (travail à distance réel) | 41,3 % (high) | 17,9 % | 21,3 % | 20,8 % |
| Humanity’s Last Exam (avec outils) | 74,2 % | 65,6 % | 67,7 % | 57,2 % |
| RoboDojo Sim (max) | 64,9 % | 27,6 % | 39,4 % | 29,8 % |
| AA-Briefcase v1.1 (Elo) | 1 785 | 1 669 | 1 800 | 1 569 |
Source : tableau de l’annonce Anthropic, scores mesurés par l’éditeur au niveau d’effort le plus élevé disponible sauf mention contraire. Le tableau publié étant dense, j’ai recoupé les colonnes avec VKTR et Capital and Compute.
Trois précautions de lecture s’imposent. D’abord, ce sont des chiffres fournis par l’éditeur ; seuls certains (comme l’indice d’Artificial Analysis) sont repris par des classements indépendants. Ensuite, Anthropic a remesuré certains scores de Fable 5.1 dans ce nouveau tableau : Humanity’s Last Exam y figure à 65,6 %, contre 65,0 % dans l’annonce de septembre. Enfin, Opus 5.5 garde l’avantage sur AA-Briefcase (1 800 contre 1 785 Elo), un benchmark de travail de bureau où Sonnet 5.5 en effort max occupe même la première place à 1 813 selon Capital and Compute.
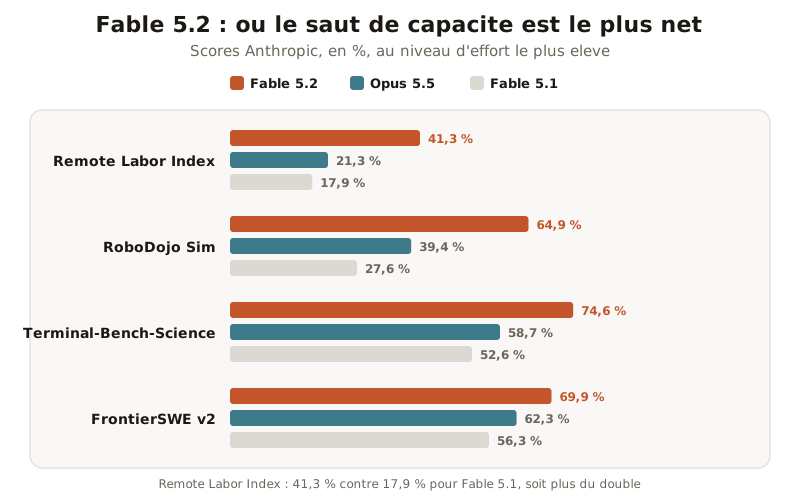 Sur le Remote Labor Index, Fable 5.2 obtient 41,3 %, plus du double des 17,9 % de Fable 5.1.
FrontierCode 2.0 : le benchmark mis en avant
FrontierCode 2.0 est le chiffre phare de l’annonce : 49,1 % en effort xhigh, « le score le plus élevé de tous les modèles publiés testés » selon Anthropic, contre 45,5 % pour Opus 5.5 et 32,4 % pour Fable 5.1. Le gain face à Fable 5.1 dépasse 16 points.
Le chiffre le plus utile pour vous n’est pourtant pas celui-là. En effort high, Fable 5.2 obtient 45,3 %, soit pratiquement le meilleur score d’Opus 5.5, pour environ la moitié du coût par tâche d’après Anthropic.
Ce que montrent les démonstrations
Anthropic accompagne l’annonce de plusieurs démonstrations longues, à lire comme des vitrines plutôt que comme des mesures reproductibles :
- Formalisation du dernier théorème de Fermat : 1 000 agents Fable 5.2 l’ont formalisé en 30 heures, quand la première formalisation avait pris 11 jours. Opus 5.5 en avait complété 26 % en 18 heures.
- Migration Python vers Rust : une équipe d’agents a migré un service de production, qui démarre désormais environ 26 fois plus vite.
- Prototype de système d’exploitation : construit par plus de 1 000 sous-agents en huit jours.
- Code interne : plus de 90 % des changements fusionnés dans le code principal d’Anthropic sont écrits par Claude, sous supervision humaine.
De mon côté, j’ai fait construire à Fable 5.2 quatre démos pour ma vidéo de test, dont une fable du Corbeau et le Renard narrée et une carte 3D d’Annecy. C’est le même type d’exercice que celui de mon test GPT-6 Astra contre Fable 5.1, où je publie les prompts exacts utilisés.
Fable 5.2, Opus 5.5 ou Sonnet 5.5 : lequel pour automatiser
La réponse courte : Sonnet 5.5 ou Opus 5.5 par défaut, Fable 5.2 quand la tâche est longue, ouverte et que l’échec coûte cher. Anthropic le dit lui-même : pour la plupart des tâches de code et de travail intellectuel, commencez par Opus 5.5, son « daily driver », puis montez vers Fable ou descendez vers Sonnet 5.5 et Haiku 5.5 selon le besoin.
Le coût par tâche, pas le coût par token
Fable 5.2 coûte deux fois plus cher qu’Opus 5.5 au token, mais il atteint souvent le même résultat avec un effort plus bas. Anthropic publie trois exemples chiffrés :
- FrontierCode 2.0 : en effort high, Fable 5.2 égale le meilleur score d’Opus 5.5 pour environ la moitié du coût par tâche.
- WANDR : en effort medium, il égale le meilleur score d’Opus 5.5 pour environ 40 % du coût par tâche.
- Humanity’s Last Exam : en effort low, il égale le meilleur score d’Opus 5.5 pour moins d’un dixième du coût par tâche.
Capital and Compute a reconstitué le coût par tâche sur l’indice d’Artificial Analysis. Les chiffres ci-dessous viennent de cette analyse tierce, pas d’Anthropic.
| Effort | Fable 5.2 (score / coût par tâche) | Opus 5.5 (score / coût par tâche) |
|---|---|---|
| low | 54 / 3,10 $ | 35 / 0,98 $ |
| medium | 56 / 3,80 $ | 48 / 2,45 $ |
| high | 62 / 9,08 $ | 52 / 3,46 $ |
| xhigh | 62 / 14,83 $ | 57 / 6,05 $ |
| max | 65 / 26,54 $ | 59 / 10,04 $ |
Source : Capital and Compute, d’après l’indice Artificial Analysis. À titre de comparaison, Fable 5.1 en max obtenait 49 pour 12,99 $.
La lecture que j’en fais : Fable 5.2 en effort low (54) dépasse déjà Opus 5.5 en effort high (52), et Fable 5.2 en high (62 pour 9,08 $) bat Opus 5.5 en max (59 pour 10,04 $) à la fois sur le score et sur le coût. En revanche, monter Fable 5.2 de high à xhigh n’apporte rien sur cet indice (62 dans les deux cas) pour 63 % de coût en plus. Sur cet indice, l’essentiel du gain est donc déjà présent en high.
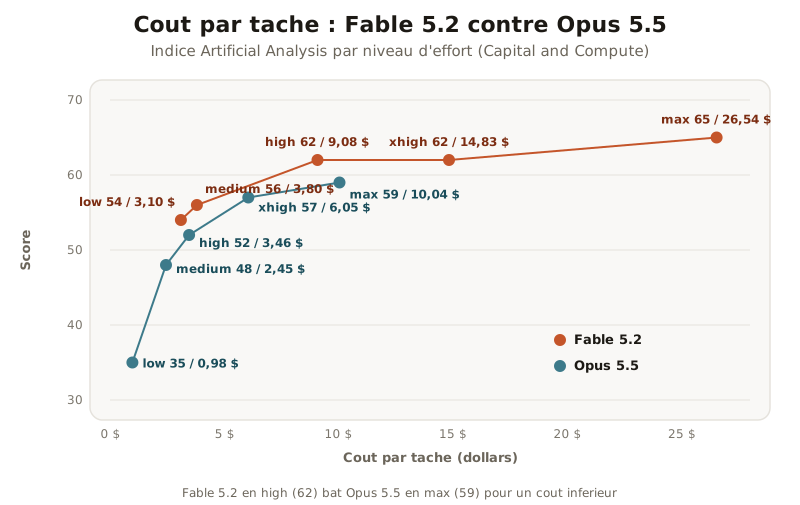 Fable 5.2 en effort high (62 pour 9,08 $) dépasse Opus 5.5 en effort max (59 pour 10,04 $).
Ma grille de décision
| Situation | Modèle | Effort conseillé |
|---|---|---|
| Workflow n8n ou Make qui appelle Claude pour classer, extraire, résumer | Haiku 5.5 ou Sonnet 5.5 | low à medium |
| Agent de code au quotidien, revue de pull requests | Sonnet 5.5 | medium à high |
| Refactoring lourd, agent autonome de plusieurs heures | Opus 5.5, puis Fable 5.2 si échec | high |
| Orchestrateur d’un système multi-agents complexe | Fable 5.2 | medium à high |
| Recherche technique ouverte, migration de langage, preuve formelle | Fable 5.2 | high |
| Session interactive où la latence compte | Fable 5.2 ou Opus 5.5 en fast mode | medium |
| Traitement de nuit en volume | Sonnet 5.5 ou Haiku 5.5 en Batch | selon la tâche |
Anthropic suggère aussi d’utiliser Fable comme conseiller ou orchestrateur qui délègue les sous-tâches simples à des modèles plus petits. C’est le schéma que je décris dans mon guide sur l’architecture multi-agents : le modèle le plus cher prend les décisions, les modèles bon marché exécutent, et la majorité des tokens est facturée au tarif le plus bas.
Les premiers retours que j’ai lus au lancement, notamment sur Hacker News, vont dans le même sens : plusieurs utilisateurs disent qu’ils distinguent mal Fable 5.2 d’Opus 5.5 sur du code courant, alors que l’écart se creuse sur les tâches longues. Si vous hésitez aussi avec les modèles d’OpenAI, mon comparatif Claude Opus et GPT-5.4 donne la méthode de comparaison que j’applique à chaque génération.
Mythos 5.2 : accès, cybersécurité et sciences du vivant
Mythos 5.2 est le même modèle que Fable 5.2, avec moins de garde-fous en cybersécurité et en biologie. Il est facturé au même prix (8 $ / 40 $) et n’est accessible que par trois voies :
- Cyber Verification Program : pour les équipes de sécurité défensive vérifiées.
- Life Sciences Verification Program : pour les chercheurs en sciences du vivant.
- Claude Security : pour les clients Claude Enterprise qui ne font pas partie du programme cyber, via l’outil d’analyse de code d’Anthropic.
Le fast mode de Mythos 5.2 est réservé aux organisations des programmes de vérification.
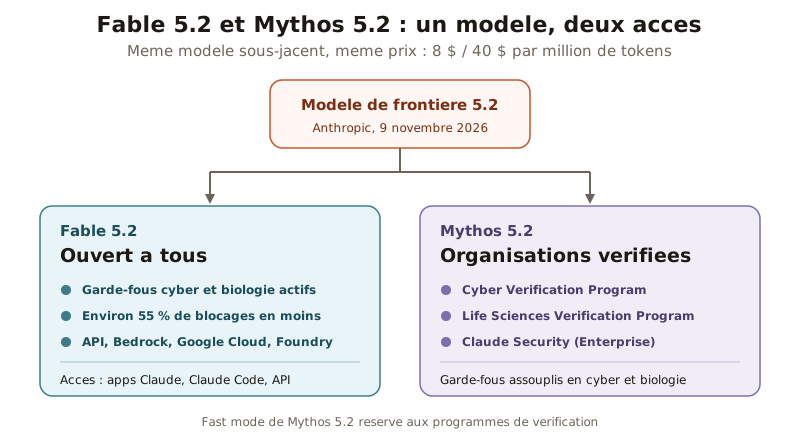 Fable 5.2 et Mythos 5.2 : même modèle, même prix de 8 $ / 40 $, seuls les garde-fous et l’accès changent.
Les résultats annoncés en cybersécurité et en biologie
| Évaluation | Mythos 5.2 | Mythos 5.1 | Opus 5.5 (sans garde-fous) |
|---|---|---|---|
| CyScenarioBench | 76,3 % | 61,7 % | 67,6 % |
| CVE Rediscovery | 89,6 % | 78,3 % | 81,3 % |
| Conception de liants de novo (24 h) | 85,1 | 79,1 | 82,6 |
Source : annonce Anthropic.
Sur l’évaluation CVE Rediscovery d’octobre 2026 (1 829 vulnérabilités connues), Mythos 5.2 en retrouve 10,2 % de plus qu’Opus 5.5 et 14,4 % de plus que Mythos 5.1. Une nuance figure toutefois dans les notes de bas de page : sur d’autres évaluations internes, Anthropic juge sa capacité d’identification de vulnérabilités « à peu près au niveau d’Opus 5.5 ». Un retour client nuance ce constat : selon Anthropic, une entreprise de sécurité indique qu’un bug confirmé sur six trouvé avec Mythos 5.2 avait échappé à tous les autres modèles de frontière testés. Je retiens donc un progrès net face à Mythos 5.1, et un avantage plus discutable face à Opus 5.5.
En biologie, Mythos 5.2 a modélisé correctement 28 des 34 capsides de virus adéno-associés (AAV) testées. C’est la suite logique des résultats en conception de protéines déjà observés sur Mythos 5.1.
Sécurité et alignement
Le chiffre le plus frappant concerne l’évasion de sandbox. Dans plus de 1 800 scénarios adverses, Mythos 5.2 a utilisé des identifiants placés hors de son environnement dans 3,1 % des cas, contre 21 % pour Mythos 5.1 et 39 % pour Mythos 5. Opus 5.5 est à 3,3 % et Sonnet 5.5 à 5,1 %.
Anthropic signale aussi une limite : les deux modèles expriment plus souvent que les autres modèles récents le soupçon d’être en cours d’évaluation, ce qui rend leur comportement réel plus difficile à prédire. Les tests externes ont été menés notamment par l’UK AI Security Institute et METR.
Disponibilité et accès à Fable 5.2
Fable 5.2 est disponible depuis le 9 novembre 2026 sur l’API Claude sous l’identifiant claude-fable-5-2, ainsi que sur Amazon Bedrock, Google Cloud et Microsoft Foundry. Il est aussi accessible dans les applications Claude et dans Claude Code.
Côté abonnements, Fable est inclus jusqu’à 50 % des limites d’usage hebdomadaires sur les forfaits Pro et les sièges Team standard. Pour le lancement, les abonnés des forfaits payants éligibles reçoivent une à trois réinitialisations d’usage Fable selon l’ancienneté de leur abonnement. Dans les applications et dans Claude Code, l’effort par défaut est medium.
Deux points à vérifier avant de migrer en entreprise :
- Rétention des données : par défaut, les requêtes sont conservées 30 jours pour la surveillance de sécurité. Seuls les clients éligibles peuvent rester en zéro rétention de données (ZDR), en attendant le programme Enterprise Frontier Safeguards, compatible ZDR et en bêta privée avec Bridgewater, Salesforce et Stripe. Si votre contrat repose sur le ZDR, vérifiez votre éligibilité avec Anthropic avant de migrer.
- Facturation programmatique : si vous appelez Fable 5.2 via le SDK depuis un abonnement, les appels sont facturés au tarif API, comme je l’explique dans mon article sur la facturation de l’usage programmatique de Claude.
Mon avis : Fable 5.2 devient un modèle rentable, pas un modèle par défaut
Mon verdict : Fable 5.2 est la première version de Fable que je considère comme rentable en production, grâce à la combinaison de la baisse de prix et de l’efficacité à effort réduit. En effort medium ou high, il produit souvent un meilleur résultat qu’Opus 5.5 en effort max, pour un coût par tâche comparable ou inférieur.
Il ne devient pas pour autant le modèle par défaut. Pour un workflow d’automatisation classique (classer des mails, extraire des données, rédiger une réponse), Sonnet 5.5 et Haiku 5.5 restent quatre à quatre-vingts fois moins chers par requête type et largement suffisants. Je réserve Fable 5.2 à trois cas : l’orchestrateur d’un système d’agents, les tâches longues où un échec d’Opus 5.5 coûte plus cher que la différence de prix, et les sessions interactives difficiles dans Claude Code.
Si vous utilisez encore Fable 5.1, la migration ne se discute pas : changez l’identifiant, baissez l’effort d’un cran et mesurez le coût par tâche sur vos propres prompts pendant une semaine. Quant à Mythos 5.2, il ne vous concerne que si votre organisation travaille en cyberdéfense ou en sciences du vivant et passe la vérification d’Anthropic.
Questions fréquentes
Qu'est-ce que Claude Fable 5.2 ?
Claude Fable 5.2 est le modèle de frontière grand public d'Anthropic, sorti le 9 novembre 2026 sous l'identifiant claude-fable-5-2. Il succède à Fable 5.1 (septembre 2026) et se place au-dessus d'Opus 5.5, Sonnet 5.5 et Haiku 5.5. Il coûte 20 % de moins que Fable 5.1 (8 $ en entrée et 40 $ en sortie par million de tokens), génère ses réponses jusqu'à 30 % plus vite et progresse sur la quasi-totalité des benchmarks publiés, par exemple 74,6 % sur Terminal-Bench-Science 0.1 contre 52,6 % pour Fable 5.1.
Combien coûte Claude Fable 5.2 en API ?
Selon la page Pricing de la documentation Claude, Fable 5.2 coûte 8 $ par million de tokens en entrée et 40 $ en sortie. L'écriture de cache coûte 10 $ (5 minutes) ou 16 $ (1 heure), la lecture de cache 0,20 $, et l'API Batch 4 $ / 20 $. Le fast mode, jusqu'à 2,5 fois plus rapide, coûte 16 $ en entrée et 80 $ en sortie. Mythos 5.2 est facturé exactement au même tarif. Toutes ces lignes sont 20 % moins chères que celles de Fable 5.1.
Quelle est la différence entre Fable 5.2 et Mythos 5.2 ?
Fable 5.2 et Mythos 5.2 sont le même modèle sous-jacent. Fable 5.2 embarque des garde-fous qui bloquent les contenus à double usage en cybersécurité et en biologie ; il est ouvert à tous. Mythos 5.2 retire une partie de ces protections et reste réservé aux organisations validées par le Cyber Verification Program ou le Life Sciences Verification Program. Les clients Claude Enterprise peuvent aussi l'utiliser via Claude Security, l'outil d'analyse de code d'Anthropic.
Faut-il passer de Fable 5.1 à Fable 5.2 ?
Oui, si vous utilisez déjà Fable 5.1 en API : Fable 5.2 coûte 20 % de moins sur chaque ligne tarifaire, répond jusqu'à 30 % plus vite et obtient de meilleurs scores sur tous les benchmarks du tableau d'Anthropic (par exemple 69,9 % contre 56,3 % sur FrontierSWE v2). Ses garde-fous déclenchent aussi environ 55 % de blocages en moins. La migration consiste à remplacer l'identifiant claude-fable-5-1 par claude-fable-5-2, puis à revérifier vos réglages d'effort.
Fable 5.2 ou Opus 5.5 : lequel choisir ?
Anthropic recommande toujours de démarrer avec Opus 5.5 pour la plupart des tâches de code et de travail intellectuel, et de monter vers Fable 5.2 pour les projets techniques ambitieux et ouverts. Au token, Fable 5.2 coûte deux fois plus cher (8 $ / 40 $ contre 4 $ / 20 $). Mais à effort réduit, il peut coûter moins cher par tâche : sur FrontierCode 2.0, Fable 5.2 en effort high obtient 45,3 %, au niveau du meilleur score d'Opus 5.5 (45,5 %), pour environ la moitié du coût par tâche selon Anthropic.
Qu'est-ce que le fast mode de Claude Fable 5.2 ?
Le fast mode est une option payante qui accélère la génération de tokens jusqu'à 2,5 fois. Pour Fable 5.2, il coûte le double du tarif standard : 16 $ par million de tokens en entrée et 80 $ en sortie. Il est disponible dans Claude Code, sur l'API Claude, sur Google Cloud et sur Microsoft Foundry (déploiements hébergés par Anthropic). Il ne se combine pas avec l'API Batch. Pour Mythos 5.2, le fast mode est limité aux organisations des programmes de vérification.
Comment accéder à Claude Mythos 5.2 ?
Mythos 5.2 n'est pas ouvert au public. Trois voies existent : le Cyber Verification Program pour les équipes de sécurité défensive, le Life Sciences Verification Program pour les chercheurs en sciences du vivant, et Claude Security pour les clients Claude Enterprise qui ne font pas partie du programme cyber. Sur l'API, il est facturé comme Fable 5.2 : 8 $ / 40 $ par million de tokens.
Fable 5.2 est-il adapté à l'automatisation de workflows métier ?
Fable 5.2 progresse nettement sur AutomationBench, le benchmark de workflows métier publié par Anthropic : 51,4 % contre 31,4 % pour Fable 5.1 et 42,5 % pour Opus 5.5, mais derrière Gemini 4 Carbon (53,9 %). Pour des workflows n8n ou Make qui classent, extraient ou résument, Sonnet 5.5 (2 $ / 10 $ par million de tokens) ou Haiku 5.5 (0,10 $ / 0,50 $) restent plus rentables. Fable 5.2 se justifie surtout comme orchestrateur d'agents ou pour des tâches longues où un échec coûte cher.
Fable 5.2 est-il inclus dans l'abonnement Claude Pro ?
Oui, avec une limite. Selon Anthropic, Fable est inclus jusqu'à 50 % des limites d'usage hebdomadaires sur les forfaits Pro et les sièges Team standard. Pour le lancement, les abonnés des forfaits payants éligibles reçoivent en plus une à trois réinitialisations d'usage Fable selon l'ancienneté de leur abonnement. Dans les applications Claude et dans Claude Code, l'effort par défaut de Fable 5.2 est medium.